Uma caixa de entrada pode reunir dúvidas comerciais, problemas técnicos, documentos e mensagens sem contexto. Uma IA pode ajudar a organizar esse volume, mas uma classificação convincente não significa que a mensagem foi compreendida corretamente. O projeto precisa definir o que será classificado, quais erros importam e o que acontece quando não há informação suficiente.
Este guia apresenta um fluxo para triagem empresarial. Não aborda decisões de elegibilidade em emprego, crédito ou outros contextos de alto impacto. O foco é organizar solicitações e encaminhá-las com revisão e limites. Os exemplos e números são hipotéticos, sem alegação de desempenho medido.
1. Defina a decisão que a classificação deve apoiar
Uma categoria só é útil se muda uma ação ou ajuda a compreender o trabalho. “Assunto geral” pode ser amplo demais; dezenas de categorias pouco distinguíveis tornam a rotulagem instável. Comece pelos destinos e responsabilidades reais da operação.
Separe assunto, intenção, prioridade e estado. Uma mensagem sobre cobrança pode ser uma dúvida, uma contestação ou o envio de um comprovante. Essas dimensões podem exigir encaminhamentos distintos. Não utilize um único rótulo para representar tudo.
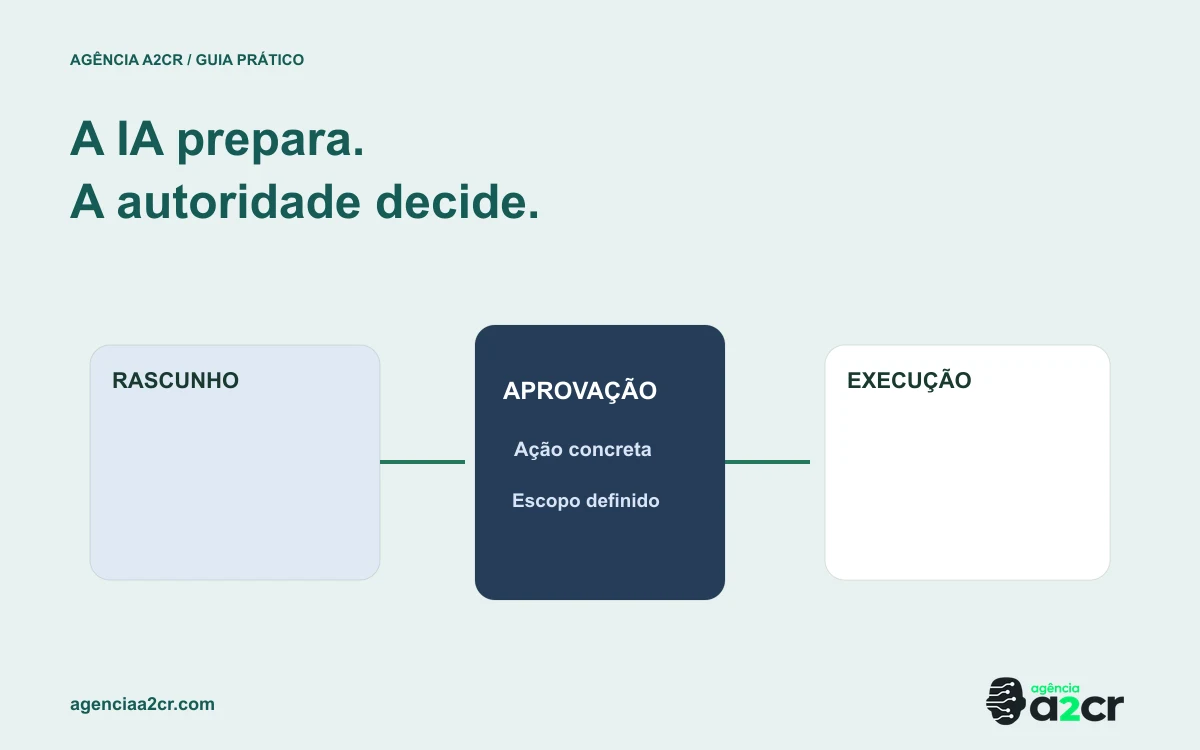
Defina também o escopo de autoridade. Classificar como pedido de cancelamento não deve executar o cancelamento. A triagem produz uma interpretação para um processo posterior, com regras e confirmação quando necessárias.
2. Construa categorias com critérios e exemplos
Para cada categoria, escreva definição, exemplos positivos, exemplos parecidos que não pertencem a ela e destino previsto. Esse material ajuda tanto o modelo quanto as pessoas que produzirão a referência de avaliação.
Casos ambíguos devem ser discutidos antes de treinar ou ajustar o classificador. Se dois analistas competentes discordam frequentemente porque a política é vaga, a IA não resolverá sozinha o problema de definição.
| Dimensão | Exemplo de saída | Uso permitido |
|---|---|---|
| Assunto | Acesso ao sistema | Selecionar equipe ou orientação |
| Intenção | Relatar falha | Preparar perguntas pertinentes |
| Informação faltante | Não identifica a unidade | Solicitar contexto mínimo |
| Encaminhamento | Revisão humana | Evitar ação baseada em interpretação incerta |
| Justificativa | Trecho que sustenta a leitura | Apoiar conferência, sem expor raciocínio especulativo |
3. Defina como tratar ausência e ambiguidade
O sistema precisa de uma saída legítima para “não foi possível classificar com segurança operacional”. Forçar sempre uma categoria produz uma fila organizada visualmente, mas potencialmente errada. O encaminhamento humano deve ser parte do desenho, não sinal de fracasso excepcional.
Um pedido de esclarecimento deve ser específico e proporcional. Se a mensagem informa o produto, não pergunte novamente. Se faltam dados de identificação, peça somente o necessário para continuar no canal apropriado.
Uma nota de confiança gerada pelo próprio modelo não deve ser assumida como probabilidade calibrada. Ela pode servir como informação auxiliar a ser avaliada, mas a política de encaminhamento precisa de testes com casos representativos e consequências conhecidas.
4. Prepare uma base de avaliação útil
Monte exemplos autorizados e devidamente tratados, ou cenários sintéticos representativos quando dados reais não puderem ser usados. Inclua mensagens curtas, erros de escrita, vários assuntos e referências a interações anteriores.
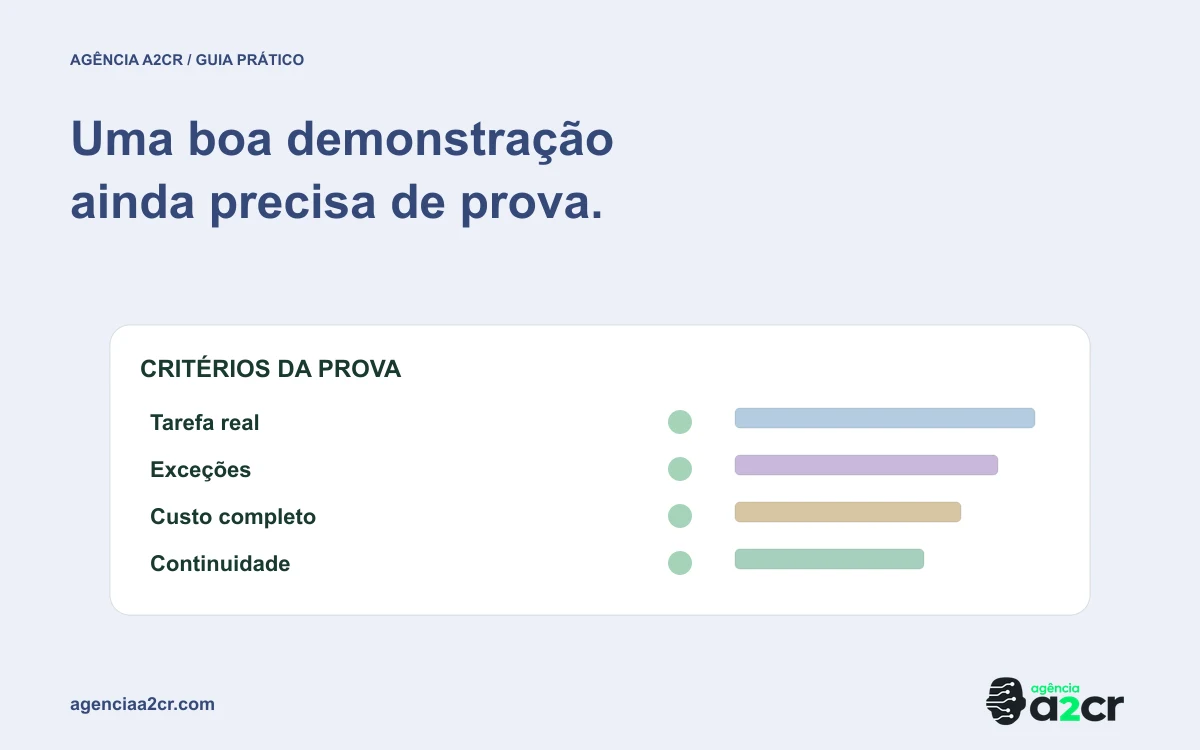
Separe os casos utilizados para desenvolver as instruções dos utilizados para avaliar mudanças. Ajustar repetidamente o prompt até acertar a mesma lista não demonstra capacidade de generalizar. Preserve um conjunto de conferência e registre versões.
A documentação de avaliação do scikit-learn apresenta medidas como precisão, recall e matriz de confusão. Elas ajudam a examinar tipos de erro, mas sua escolha deve refletir a decisão operacional. Um único percentual global pode esconder desempenho fraco em uma categoria importante.
5. Avalie o custo dos erros por categoria
Encaminhar uma dúvida comercial para suporte pode atrasar uma resposta. Tratar uma contestação sensível como mensagem promocional pode ter consequência diferente. A empresa deve definir quais erros exigem revisão ou interrupção.
Observe falsos encaminhamentos, casos não reconhecidos e volume de revisão humana. Uma configuração que reduz revisão a quase zero pode aumentar erros invisíveis. Outra que encaminha tudo não oferece o mesmo benefício operacional, embora possa ser uma etapa inicial segura.
Compare políticas por categoria, em vez de procurar um limiar universal. O critério de sucesso deve incluir qualidade do destino e utilidade do contexto entregue à equipe, não apenas acerto de um rótulo em uma planilha.
6. Exemplo: mensagem com dois assuntos
Um cliente escreve que não consegue acessar o painel e também quer alterar o responsável pelo contrato. A classificação única “acesso” pode resolver apenas parte da necessidade. O sistema deve conseguir reconhecer múltiplas intenções ou sinalizar que há um segundo fluxo.
O encaminhamento pode abrir tarefas relacionadas, preservando a mensagem e o contexto. Alterar o responsável pelo contrato requer uma validação distinta de orientar recuperação de acesso. A IA não deve executar a mudança apenas porque a intenção foi reconhecida.
Na revisão, a equipe confirma se a interpretação faz sentido e registra a correção quando necessário. Esse retorno alimenta a melhoria das definições. Não é preciso expor ao cliente uma sequência de rótulos internos para oferecer um atendimento organizado.
7. Use saída estruturada e validação externa
Solicite campos conhecidos e valores permitidos, com tratamento para ausência. O backend deve verificar se a saída é válida antes de utilizá-la. Uma resposta em formato correto ainda pode conter uma interpretação errada, portanto validação estrutural e avaliação semântica são complementares.
Não transforme texto livre em comando operacional. O destino deve ser resolvido a partir de uma lista autorizada. O modelo não deve inventar um endereço de equipe, uma URL de integração ou um identificador de cliente para completar a resposta.
Preserve a referência da mensagem e a versão do classificador utilizada. Quando uma regra mudar, será possível comparar comportamento e investigar um encaminhamento antigo sem depender do modelo atualmente em produção.
8. Proteja contexto e limites de acesso
O classificador deve receber apenas informações necessárias à tarefa. Acesso a todo o histórico da empresa pode ampliar risco e custo sem melhorar a decisão. Recupere contexto com escopo por atendimento e permissões apropriadas.
Mensagens e documentos são dados, não instruções administrativas para o sistema. Uma pessoa pode escrever algo que pareça ordem ao modelo; isso não deve alterar sua autorização ou os destinos permitidos. A política precisa existir na aplicação, além das instruções de linguagem.
Para aprofundar fronteiras entre contexto e ação, consulte o centro de IA aplicada da A2CR. A classificação é uma etapa de um sistema maior, com dados, ferramentas e decisões humanas.
9. Implante com observação e possibilidade de retorno
Uma primeira etapa pode apenas sugerir rótulos para conferência, sem mudar filas automaticamente. Depois de avaliar os resultados, a empresa pode autorizar encaminhamentos específicos. O avanço deve depender de evidência e risco, não de entusiasmo com uma demonstração.
Registre mudanças, compare categorias e acompanhe correções. Um novo produto, canal ou tipo de cliente pode alterar a distribuição das mensagens. A orientação de critérios e avaliações da Anthropic reforça a utilidade de critérios mensuráveis; o método deve ser aplicado ao caso, independentemente do fornecedor escolhido.
Checklist de implantação
- Definir a decisão apoiada por cada rótulo.
- Separar assunto, intenção, prioridade e estado.
- Documentar exemplos e fronteiras das categorias.
- Criar saída para ambiguidade e informação insuficiente.
- Avaliar erros por categoria e consequência.
- Separar desenvolvimento e conferência das instruções.
- Validar formato e destinos no backend.
- Limitar contexto e preservar referência da mensagem.
- Implantar inicialmente com observação quando adequado.
- Monitorar correções e mudanças na demanda.
Checklist para usar com sua equipe
Baixe o checklist editável em CSV e registre a conferência, o responsável e as observações da implantação.
Perguntas frequentes
Preciso de um modelo grande para classificar mensagens?
Não necessariamente. A escolha depende de categorias, contexto, qualidade esperada, latência e custo. Uma solução mais simples pode atender bem a uma tarefa delimitada, desde que seja avaliada com dados pertinentes.
Acurácia alta comprova que o fluxo está pronto?
Não. É necessário entender a distribuição das categorias, o custo de cada erro, a qualidade da referência e os efeitos do encaminhamento. Um resultado agregado pode ocultar falhas relevantes.
Posso transformar a classificação em resposta automática?
Somente depois de definir autoridade, conteúdo e critérios de segurança do fluxo correspondente. Identificar um assunto não comprova que há informação suficiente para responder ou executar uma ação.
Para estruturar uma triagem com IA, prepare um briefing com exemplos de mensagens e destinos atuais. A A2CR pode desenhar avaliação e encaminhamento antes de automatizar decisões.
Autoria: Agência A2CR. Preparação editorial: 12 de novembro de 2026. Exemplos hipotéticos; nenhum percentual de desempenho deste artigo representa resultado de uma implantação real.